

卢志武 长聘教授
返回列表邮箱:luzhiwu(@)mdav88.net
个人网页://mdav88.net/szdw/zrjs/lzw
卢志武博士,麻豆av 长聘教授,博士生导师。2005年毕业于北京大学数学科学麻豆av 信息科学系,获理学硕士学位;2011年毕业于香港城市大学计算机系,获PhD学位。主要研究方向为机器学习与计算机视觉。设计首个公开的中文通用图文预训练模型文澜BriVL,早于OpenAI发布类Sora的视频生成底座VDT,并因此获评南风窗2024年度科学家。以主要作者身份发表学术论文100余篇,其中在Nat Commun、TPAMI、IJCV等国际期刊和ICML、ICLR、NeurIPS、CVPR、ICCV等国际会议上发表论文60余篇。指导学生获得CCF优博、百度奖学金、吴玉章奖、“京东杯”创业大赛特等奖、中国国际大学生创新大赛金奖。担任CCF生物信息学专委会委员、全国广播电影电视标准化技术委员会委员。担任ICLR、UAI等国际顶级会议的领域主席。
工作经历
2019年8月—现在,麻豆av
,教授
2013年9月—2019年7月,麻豆av 信息麻豆av ,副教授
2011年5月—2013年7月,北京大学计算机所,助理研究员
研究方向
计算机视觉:多模态大模型,大模型后训练,视频生成,世界模型,具身智能
机器学习:强化学习,连续学习,自监督学习,元学习,小样本学习
南风窗报道://mp.weixin.qq.com/s/pV6xZ4wTIJH0UoBfMft8Sg
量子位报道://mp.weixin.qq.com/s/oXAx-b0ci7R8WHOYsf10gg
机器之心报道://mp.weixin.qq.com/s/qpg_UPGO_T4kpeZAm_pniw
研究成果
学生要求
对研究有浓厚兴趣,自我驱动力强,有较好的动手能力
学生去向:北卡教堂山分校助理教授,月之暗面 Kimi模型视觉负责人,中山大学助理教授,智子引擎CEO,华北电力大学教职,普渡大学助理教授,字节跳动(美国)研究科学家
教授课程
研究生课:《高级机器学习》,《小样本学习》,《自然语言处理》
本科生课:《迁移学习》,《统计学习》
科研项目
国家自然科学基金重点项目(课题),面向智慧教育的多模态模型构建方法,2025.01-2029.12,主持
国家自然科学基金面上项目,大规模多模态预训练的关键问题研究,2024.01-2027.12,主持
华为-人大联合项目,基于多任务自监督与稀疏激活的多模态语义模型,2022.02-2023.02,主持
联通-人大联合项目,面向联通业务场景的大规模预训练模型,2022.07-2023.11,主持
阿里达摩院合作项目,面向视觉语言的多模态特征学习,2020.09-2021.09,主持
国家自然科学基金面上项目,小样本学习关键问题研究,2020.01-2023.12,主持
国家自然科学基金面上项目,噪声环境下的弱监督图像语义分割研究,2016.01-2019.12,主持
荣誉奖励
指导学生获得2025年吴玉章奖
指导学生获得2025年“京东杯”创业大赛特等奖
南风窗2024年度科学家
昇腾AI创新大赛2023全国总决赛应用赛道银奖
麻豆av 2022年度优秀科研成果奖特等奖
Top 25 Nature Communications social science and human behavior articles of 2022
AISTATS 2022 Top reviewer
NeurIPS 2021 Outstanding Reviewer Award
指导学生获得2021年CCF优博
指导学生获得2021年百度奖学金
2021年设计首个公开的中文通用图文预训练模型文澜BriVL
ICONIP 2018最佳学生论文奖亚军
2015年IBM SUR Award
麻豆av 2015届优秀学士学位论文指导老师
计算机图形学国际会议CGI 2014最佳论文奖
社会兼职
CCF生物信息学专委会委员
全国广播电影电视标准化技术委员会委员
ICLR、UAI等国际顶级会议的领域主席
学术论文
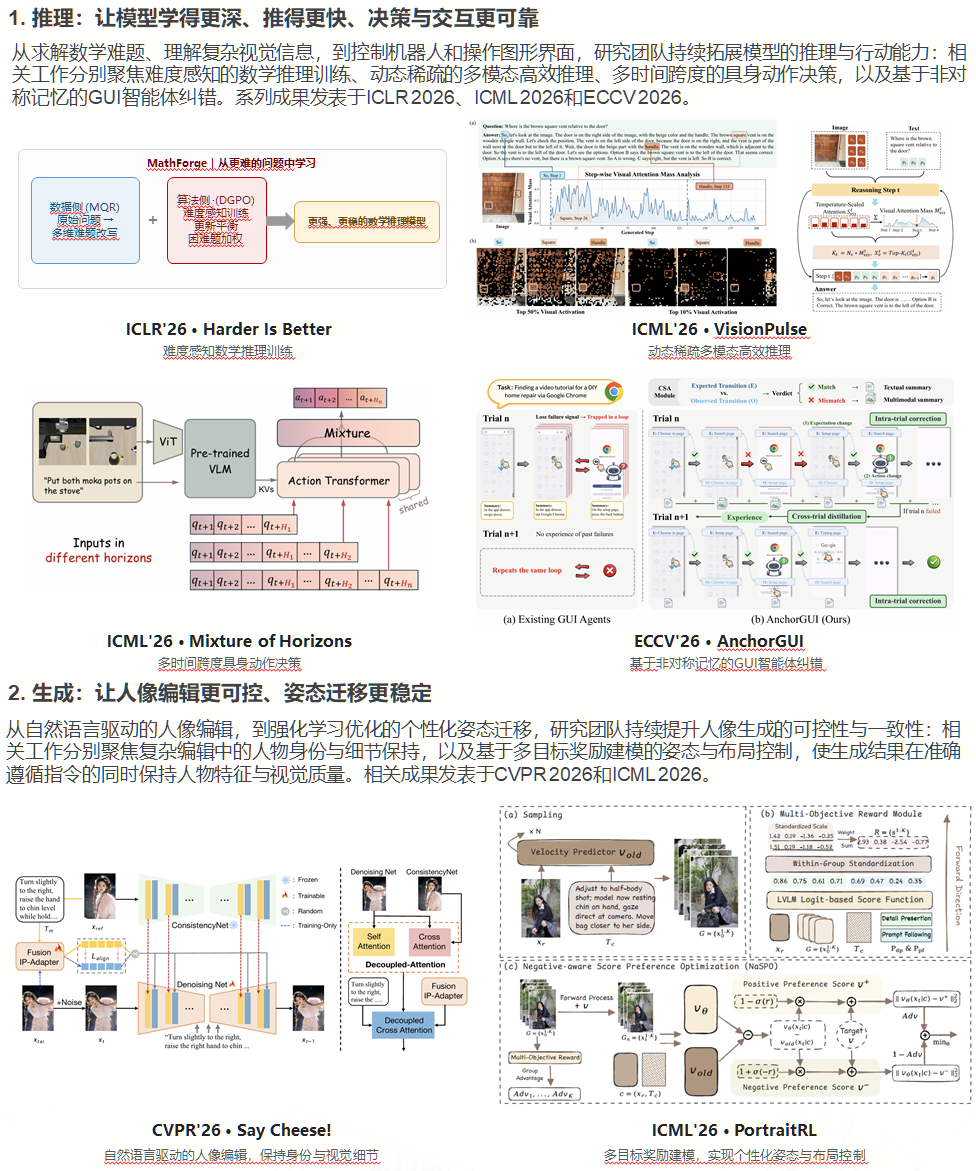
● Shengjie Jin, Zelong Sun, Hengbo Xu, Yanbiao Ma, and Zhiwu Lu*, AnchorGUI: Asymmetric Memory for Dual-Scale Learning in GUI Navigation, European Conference on Computer Vision (ECCV), 2026. [PDF]
● Hengbo Xu, Shengjie Jin, Yanbiao Ma, and Zhiwu Lu*, VisionPulse: Dynamic Visual Sparsity for Efficient Multimodal Reasoning, International Conference on Machine Learning (ICML), 2026. [PDF]
● Jiahui Wu, Zelong Sun, Yanbiao Ma, and Zhiwu Lu*, PortraitRL: Reinforcement Learning for Personalized Portrait Pose Transfer with Multi-Objective Reward, International Conference on Machine Learning (ICML), 2026. [PDF]
● Dong Jing, Gang Wang, Jiaqi Liu, Weiliang Tang, Zelong Sun, Yunchao Yao, Zhenyu Wei, Yunhui Liu, Zhiwu Lu*, and Mingyu Ding, Mixture of Horizons in Action Chunking, International Conference on Machine Learning (ICML), 2026. [PDF]
● Yanqi Dai, Yong Wang, Zebin You, Dong Jing, Xiangxiang Chu and Zhiwu Lu*, Adaptive Task Balancing for Visual Instruction Tuning via Inter-Task Contribution and Intra-Task Difficulty, ACM Web Conference (WWW), 2026. (Oral) [PDF]
● Zelong Sun, Jiahui Wu, Ying Ba, Dong Jing, and Zhiwu Lu*, Say Cheese! Detail-Preserving Portrait Collection Generation via Natural Language Edits, IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2026. [PDF]
● Yanqi Dai, Yuxiang Ji, Xiao Zhang, Yong Wang, Xiangxiang Chu, and Zhiwu Lu*, Harder Is Better: Boosting Mathematical Reasoning via Difficulty-Aware GRPO and Multi-Aspect Question Reformulation, International Conference on Learning Representations (ICLR), 2026. [PDF]
● Zelong Sun, Dong Jing, and Zhiwu Lu*, CoTMR: Chain-of-Thought Multi-Scale Reasoning for Training-Free Zero-Shot Composed Image Retrieval, IEEE International Conference on Computer Vision (ICCV), pp. 22675-22684, 2025. [PDF]
● Yanqi Dai, Huanran Hu, Lei Wang, Shengjie Jin, Xu Chen*, and Zhiwu Lu*, MMRole: A Comprehensive Framework for Developing and Evaluating Multimodal Role-Playing Agents, International Conference on Learning Representations (ICLR), 2025. [PDF]
● Zelong Sun, Dong Jing, Guoxing Yang, Nanyi Fei, and Zhiwu Lu*, Leveraging Large Vision-Language Model as User Intent-Aware Encoder for Composed Image Retrieval, AAAI Conference on Artificial Intelligence (AAAI), pp. 7149-7157, 2025. [PDF]
● Feifei Fu and Zhiwu Lu*, Enhancing Data-Free Class-Incremental Learning via Image-Centric Dual Distillation, IEEE International Conference on Acoustics, Speech and SP (ICASSP), 2025. [PDF]
● Dong Jing, Xiaolong He, Yutian Luo, Nanyi Fei, Guoxing Yang, Wei Wei, Huiwen Zhao, and Zhiwu Lu*, FineCLIP: Self-distilled Region-based CLIP for Better Fine-grained Understanding, Annual Conference on Neural Information Processing Systems (NeurIPS), pp. 27896-27918, 2024. [PDF]
● Yutian Luo, Shiqi Zhao, Haoran Wu, and Zhiwu Lu*, Dual-Enhanced Coreset Selection with Class-Wise Collaboration for Online Blurry Class Incremental Learning, IEEE Conference on Computer Vision and Pattern Recognition (CVPR), pp. 23995-24004, 2024. [PDF]
● Haoyu Lu, Yuqi Huo, Guoxing Yang, Zhiwu Lu*, Wei Zhan, Masayoshi Tomizuka, and Mingyu Ding, UniAdapter: Unified Parameter-Efficient Transfer Learning for Cross-modal Modeling, International Conference on Learning Representations (ICLR), 2024. [PDF]
● Haoyu Lu, Guoxing Yang, Nanyi Fei, Yuqi Huo, Zhiwu Lu*, Ping Luo, and Mingyu Ding, VDT: General-purpose Video Diffusion Transformers via Mask Modeling, International Conference on Learning Representations (ICLR), 2024. [PDF]
● Feifei Fu, Yizhao Gao, Zhiwu Lu*, Haoran Wu, and Shiqi Zhao, Unsupervised Continual Learning of Image Representation Via Rememory-Based Simsiam, IEEE International Conference on Acoustics, Speech and SP (ICASSP), pp. 4980-4984, 2024. [PDF]
● Zelong Sun, Guoxing Yang, Zhiwu Lu*, Hao Jiang, Guojie Zhu, and Zhao Cao, Image Retrieval with Composed Query by Multi-Scale Multi-Modal Fusion, IEEE International Conference on Acoustics, Speech and SP (ICASSP), pp. 5950-5954, 2024. [PDF]
● Yiming Zhao, Haoyu Lu, Shiqi Zhao, Haoran Wu, and Zhiwu Lu*, Multi-Level Contrastive Learning For Hybrid Cross-Modal Retrieval, IEEE International Conference on Acoustics, Speech and SP (ICASSP), pp. 6390-6394, 2024. [PDF]
● Guoxing Yang, Haoyu Lu, Chongxuan Li, Guang Zhou, Haoran Wu, and Zhiwu Lu*, Progressive Image Synthesis from Semantics to Details with Denoising Diffusion GAN, IEEE International Conference on Acoustics, Speech and SP (ICASSP), pp. 7495-7499, 2024. [PDF]
● Feifei Fu, Yizhao Gao, and Zhiwu Lu*, Enhancing Class-Incremental Learning for Image Classification via Bidirectional Transport and Selective Momentum, ACM International Conference on Multimedia Retrieval (ICMR), pp. 175-183, 2024. [PDF]
● Jinqiang Long, Yizhao Gao, and Zhiwu Lu*, Mixup-Inspired Video Class-Incremental Learning, IEEE International Conference on Data Mining (ICDM), pp. 1181-1186, 2023. [PDF]
● Guoxing Yang, Feifei Fu, Nanyi Fei, Haoran Wu, Ruitao Ma, and Zhiwu Lu*, DiST-GAN: Distillation-based Semantic Transfer for Text-Guided Face Generation, IEEE International Conference on Multimedia and Expo (ICME), pp. 840-845, 2023. [PDF]
● Yizhao Gao and Zhiwu Lu*, CMMT: Cross-Modal Meta-Transformer for Video-Text Retrieval, ACM International Conference on Multimedia Retrieval (ICMR), pp. 76-84, 2023. (Best Paper Candidate) [PDF]
● Guoxing Yang, Haoyu Lu, Zelong Sun, and Zhiwu Lu*, Shot Retrieval and Assembly with Text Script for Video Montage Generation, ACM International Conference on Multimedia Retrieval (ICMR), pp. 298-306, 2023. [PDF]
● Yutian Luo, Yizhao Gao, and Zhiwu Lu*, Learning with Adaptive Knowledge for Continual Image-Text Modeling, ACM International Conference on Multimedia Retrieval (ICMR), pp. 472-480, 2023. [PDF]
● Yanqi Dai, Nanyi Fei, and Zhiwu Lu*, Improvable Gap Balancing for Multi-Task Learning, 39th Conference on Uncertainty in Artificial Intelligence (UAI), pp. 496-506, 2023. [PDF]
● Nanyi Fei, Zhiwu Lu*, Yizhao Gao, Guoxing Yang, Yuqi Huo, Jingyuan Wen, Haoyu Lu, Ruihua Song, Xin Gao, Tao Xiang, Hao Sun* and Ji-Rong Wen*, Towards artificial general intelligence via a multimodal foundation model, Nature Communications, vol. 13, article no. 3094, 2022. (132k Accesses, 414 citations) [PDF]
● Yizhao Gao, Nanyi Fei, Haoyu Lu, Zhiwu Lu*, Hao Jiang, Yijie Li, and Zhao Cao, BMU-MoCo: Bidirectional Momentum Update for Continual Video-Language Modeling, Annual Conference on Neural Information Processing Systems (NeurIPS), pp. 22699-22712, 2022. (Spotlight) [PDF]
● Jiechao Guan, Yong Liu, and Zhiwu Lu*, Fine-Grained Analysis of Stability and Generalization for Modern Meta Learning Algorithms, Annual Conference on Neural Information Processing Systems (NeurIPS), pp. 18487-18500, 2022. (Spotlight) [PDF]
● Haoyu Lu, Mingyu Ding, Nanyi Fei, Yuqi Huo, and Zhiwu Lu*, LGDN: Language-Guided Denoising Network for Video-Language Modeling, Annual Conference on Neural Information Processing Systems (NeurIPS), pp. 25198-25211, 2022. (Spotlight) [PDF]
● Jiechao Guan and Zhiwu Lu*, Fast-Rate PAC-Bayesian Generalization Bounds for Meta-Learning, International Conference on Machine Learning (ICML), pp. 7930-7948, 2022. [PDF]
● Haoyu Lu, Nanyi Fei, Yuqi Huo, Yizhao Gao, Zhiwu Lu*, and Ji-Rong Wen, COTS: Collaborative Two-Stream Vision-Language Pre-Training Model for Cross-Modal Retrieval, IEEE Conference on Computer Vision and Pattern Recognition (CVPR), pp. 15671-15680, 2022. [PDF]
● Jiechao Guan and Zhiwu Lu*, Task Relatedness-Based Generalization Bounds for Meta Learning, International Conference on Learning Representations (ICLR), 2022. (Spotlight) [PDF]
● Hongfeng Han, Nanyi Fei, Zhiwu Lu*, and Ji-Rong Wen, Supervised Contrastive Learning for Few-Shot Action Classification, European Conference on Machine Learning and Knowledge Discovery in Databases (ECML PKDD), pp. 512-528, 2022. [PDF]
● Jingyuan Wen, Yutian Luo, Nanyi Fei, Guoxing Yang, Zhiwu Lu*, Hao Jiang, Jie Jiang, and Zhao Cao, Visual Prompt Tuning for Few-Shot Text Classification, International Conference on Computational Linguistics (COLING), pp. 5560-5570, 2022. [PDF]